你问 ChatGPT 一个问题,它在回答前到底搜了什么?
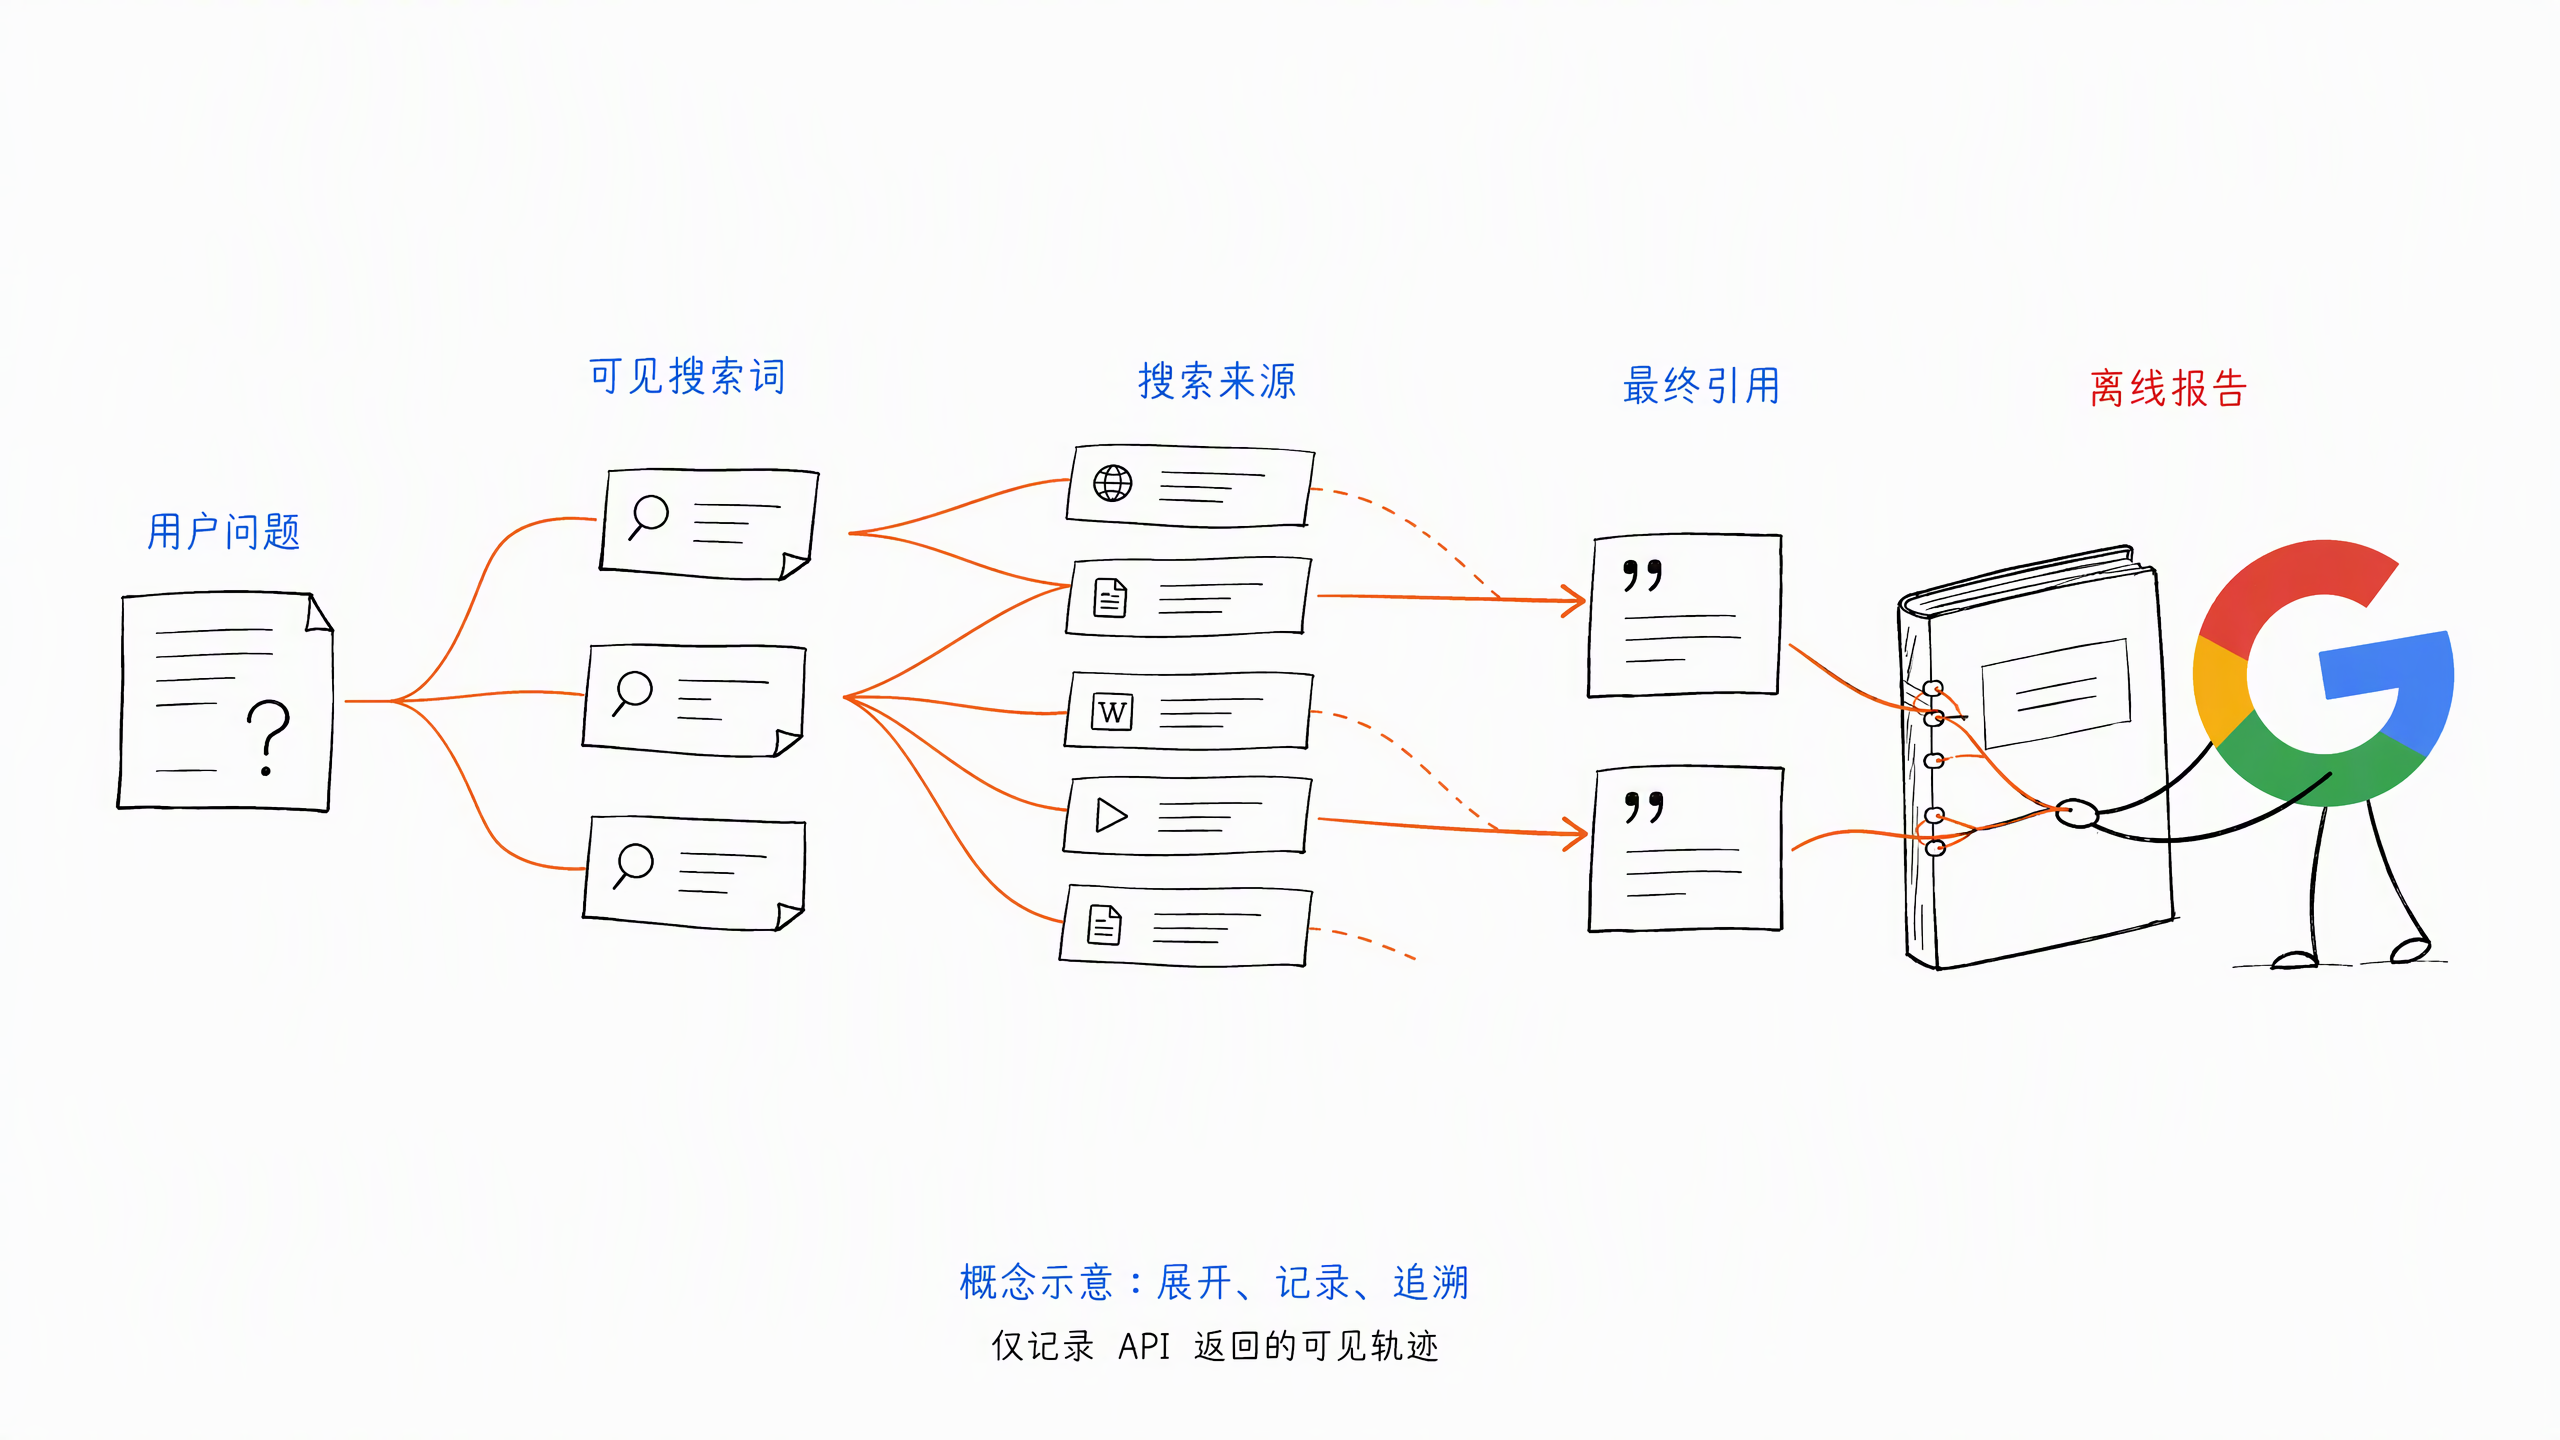
对做 GEO 的人来说,关键不只是答案,还包括:问题被展开成了哪些搜索词、搜索返回了哪些来源,以及哪些页面最终被引用。手动追踪这条链路很麻烦:要调 Responses API、开启 Web Search、保存完整 JSON,再从层层 output 中找 web_search_call、queries、sources 和 url_citation。而且,搜索返回的来源不等于最终答案引用的来源。
所以我把这套流程做成了 Agent Skill:chatgpt-fanout-queries。
给它一个真实问题,它会保留 API 返回的可见搜索轨迹,提取搜索词、工具调用、来源 URL、最终引用和回答,并生成可离线打开的 HTML 报告。
开源 + 免费,欢迎用起来、提 Issue、一起把它做得更实用。
GitHub 地址:
https://github.com/JeffLi1993/open-growth-skills/tree/main/chatgpt-fanout-queries/
一、为什么做这个 Skill?
Query fan-out 已经成了 GEO 里一个很重要的视角。
用户输入的可能只是一句“best ai video generator”,但模型搜索时会把它展开成更具体的方向:某个产品的导出能力、某个工具的 AI 生成功能、某个平台的使用场景。你的页面能不能被看见,往往取决于它是否命中了这些展开后的需求。
这个 Skill 做的,就是把展开后的搜索词、搜索来源和最终引用原样拿出来。它只记录 Responses API 实际返回的内容。如图:
这些输出能拿来做什么?
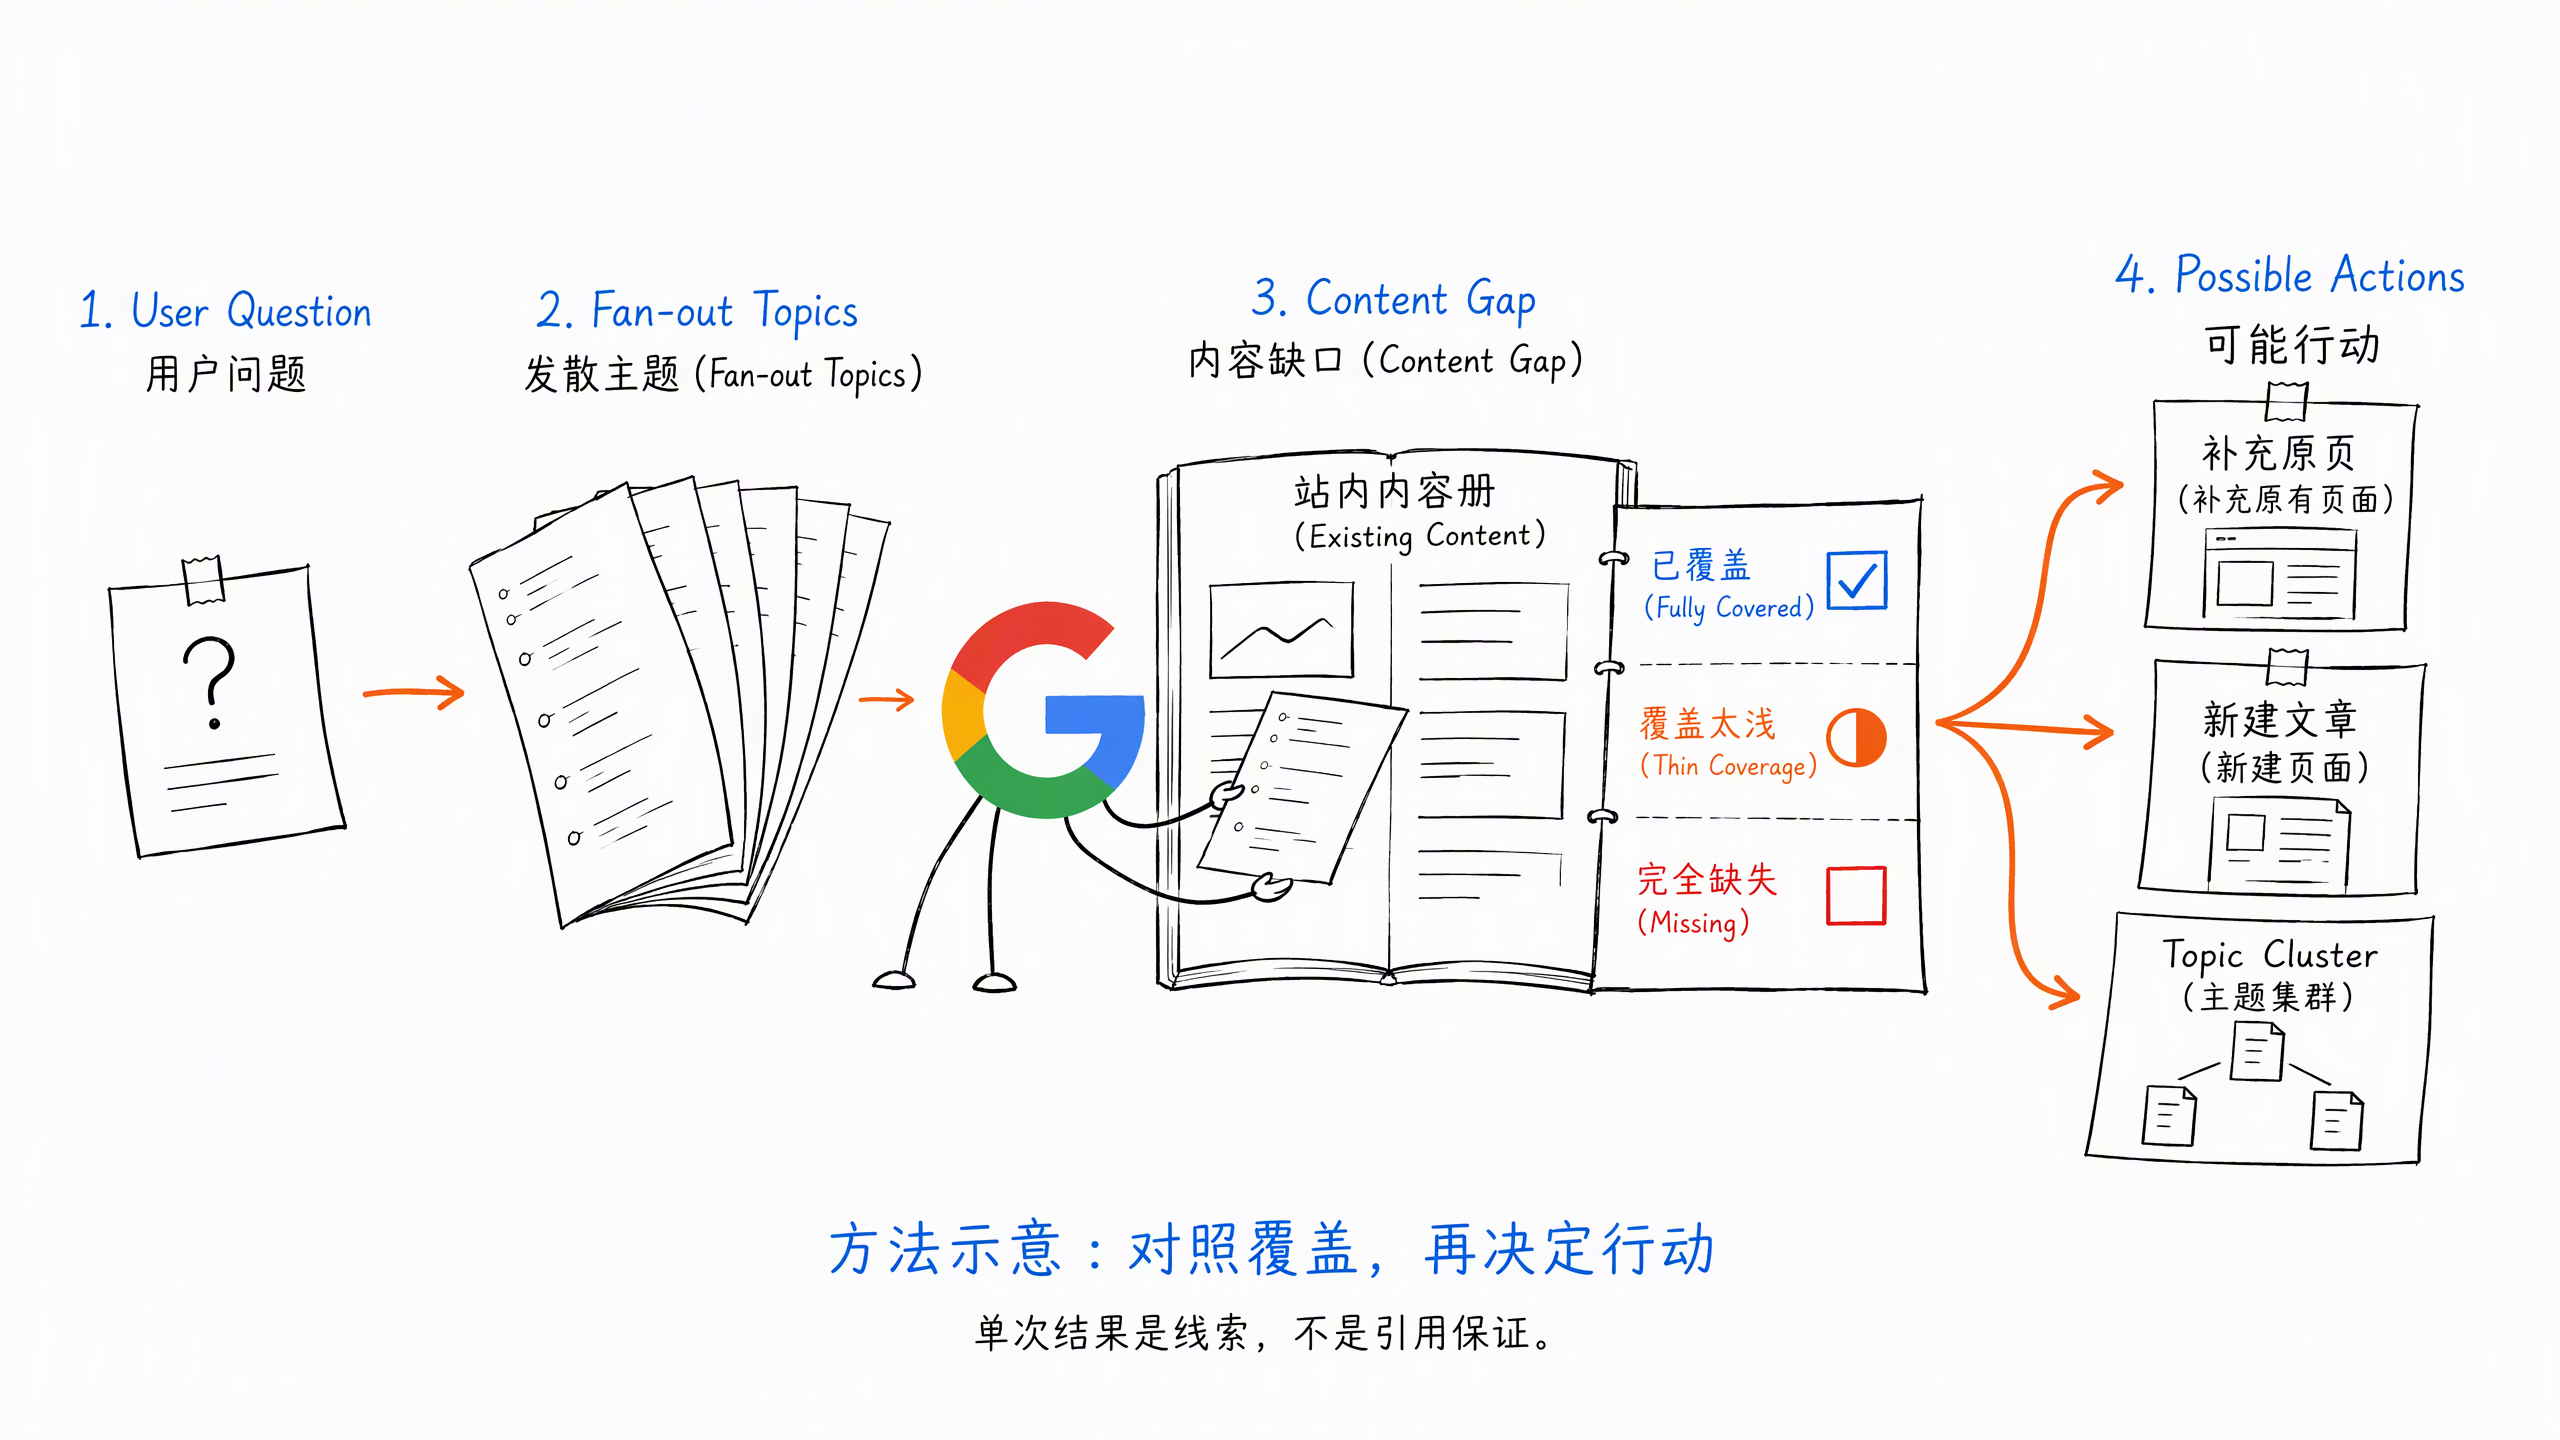
一句话:把 AI 的可见搜索词和你的站内内容对照,找出已覆盖、覆盖太浅和完全缺失的 topic。 落到内容营销上,主要有四种用法:
补齐主题覆盖:AI 围绕核心问题还会搜哪些子主题,站内哪些还没回答
发现内容缺口:对比搜索词、搜索来源和已有页面,找出值得新增的实体、场景、比较关系和用户问题
调整内容结构:把反复出现的搜索意图组织成专题页、支柱页和内链,搭成 Topic Cluster,而不是零散追单个关键词
排内容优先级:结合来源类型和最终引用,判断这个主题更适合做产品页、比较页、教程、案例还是数据型内容
要提醒的是,单次结果只是选题线索,不代表搜索量、排名难度,也不保证被 AI 引用。更稳的做法是用多组真实问题重复运行,再结合已有关键词、GSC 数据和业务相关性判断。
开源 + 免费,欢迎用起来、提 Issue、一起把它做得更实用。
GitHub 地址:
https://github.com/JeffLi1993/open-growth-skills
二、它具体会做什么?
整个工作流不是一句 prompt 碰运气,而是一条可复现的数据流程:
原问题直送:不重写、不偷加研究指令,便于对比不同模型和参数
保存原始响应:先写入完整
raw-response.json,再做任何解析提取可见搜索词:只保留 API 实际返回的
queries或query分开来源与引用:搜索结果出现过,不等于最终答案使用了它
保留调用记录:搜索、打开页面、页内查找分开计数
生成结构化产物:JSON、CSV、Markdown 和一份完整 HTML 报告
附加白话概览:在线模式下,默认再调用一次同一模型,根据已采集数据概括搜索角度、来源类型与明显遗漏
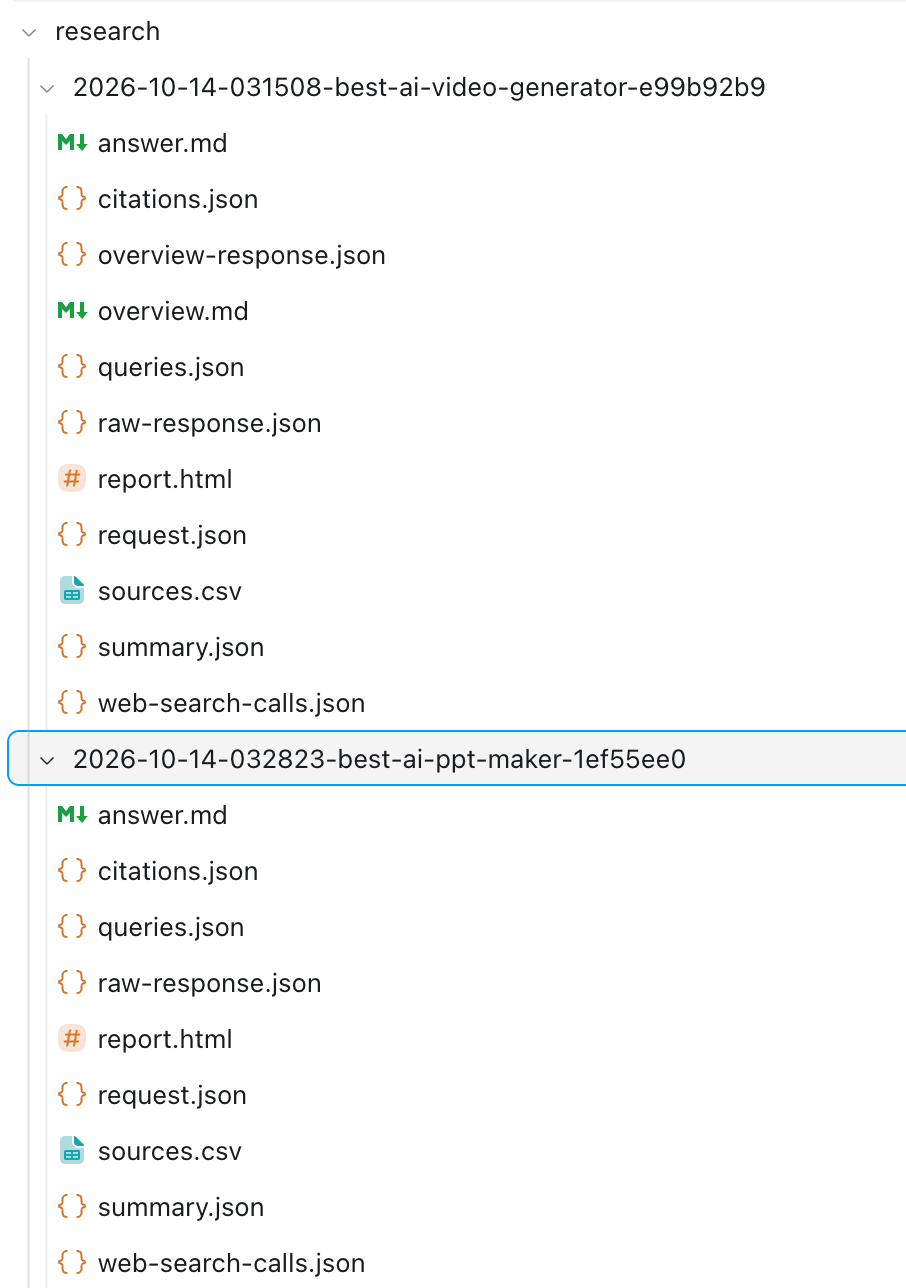
每次运行都会建立一个独立目录,里面保留:
| 文件 | 用途 |
|---|---|
raw-response.json |
完整 API 原始响应 |
request.json |
原问题与请求参数,不含 API Key |
summary.json |
模型、状态、用量、调用与来源统计 |
queries.json |
API 暴露的 fan-out 搜索词 |
web-search-calls.json |
原样保留的 Web Search 工具调用 |
sources.csv |
搜索来源与引用 URL 的并集 |
citations.json |
最终答案里的 URL 引用与原始偏移 |
answer.md |
回答正文与去重后的引用链接 |
overview.md |
模型生成的中文概览,可选 |
report.html |
自包含、可离线打开的可视化报告 |
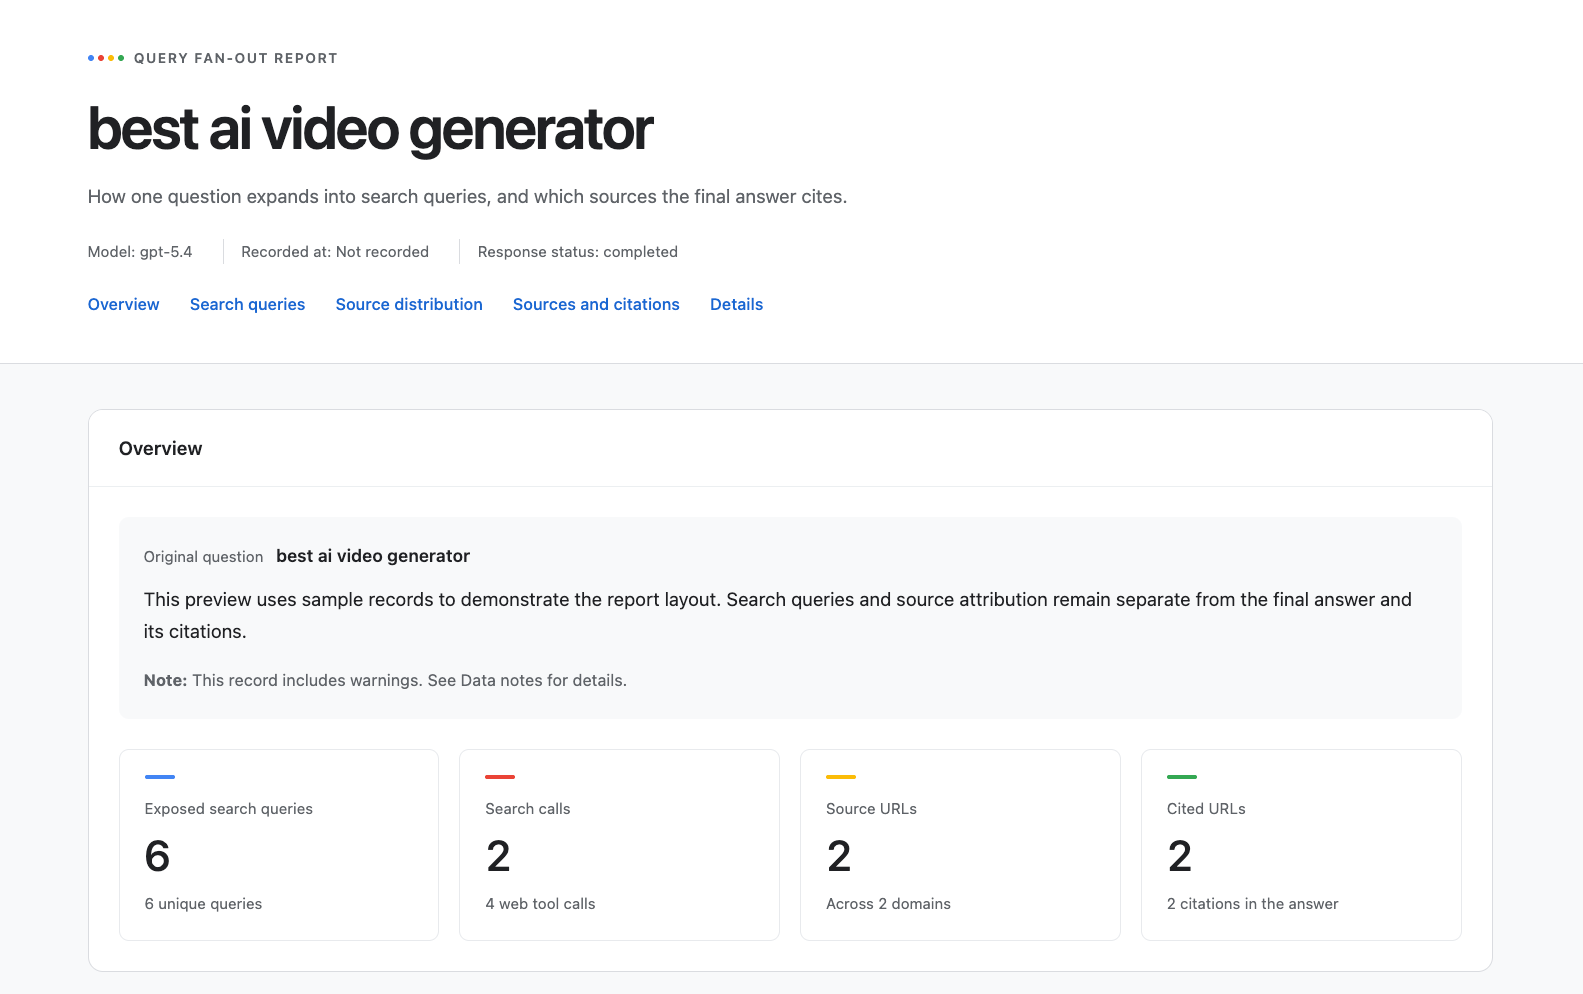
数据是可以继续分析的,报告是可以直接给人看的。如图:best ai ppt maker 、best ai video generator 案例:
三、一个真实案例
我用这个 Skill 跑了一次:best ai ppt maker
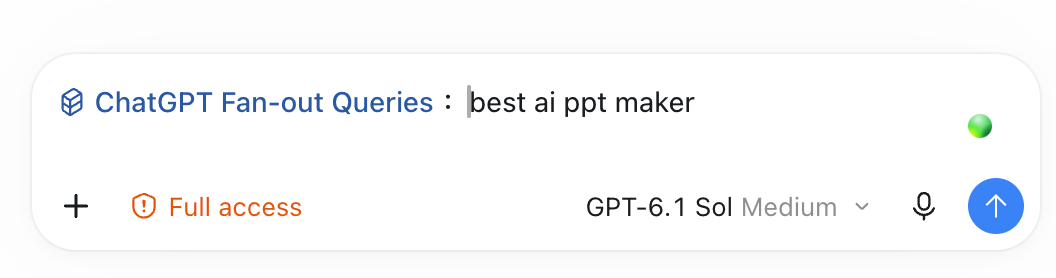
结果如下:
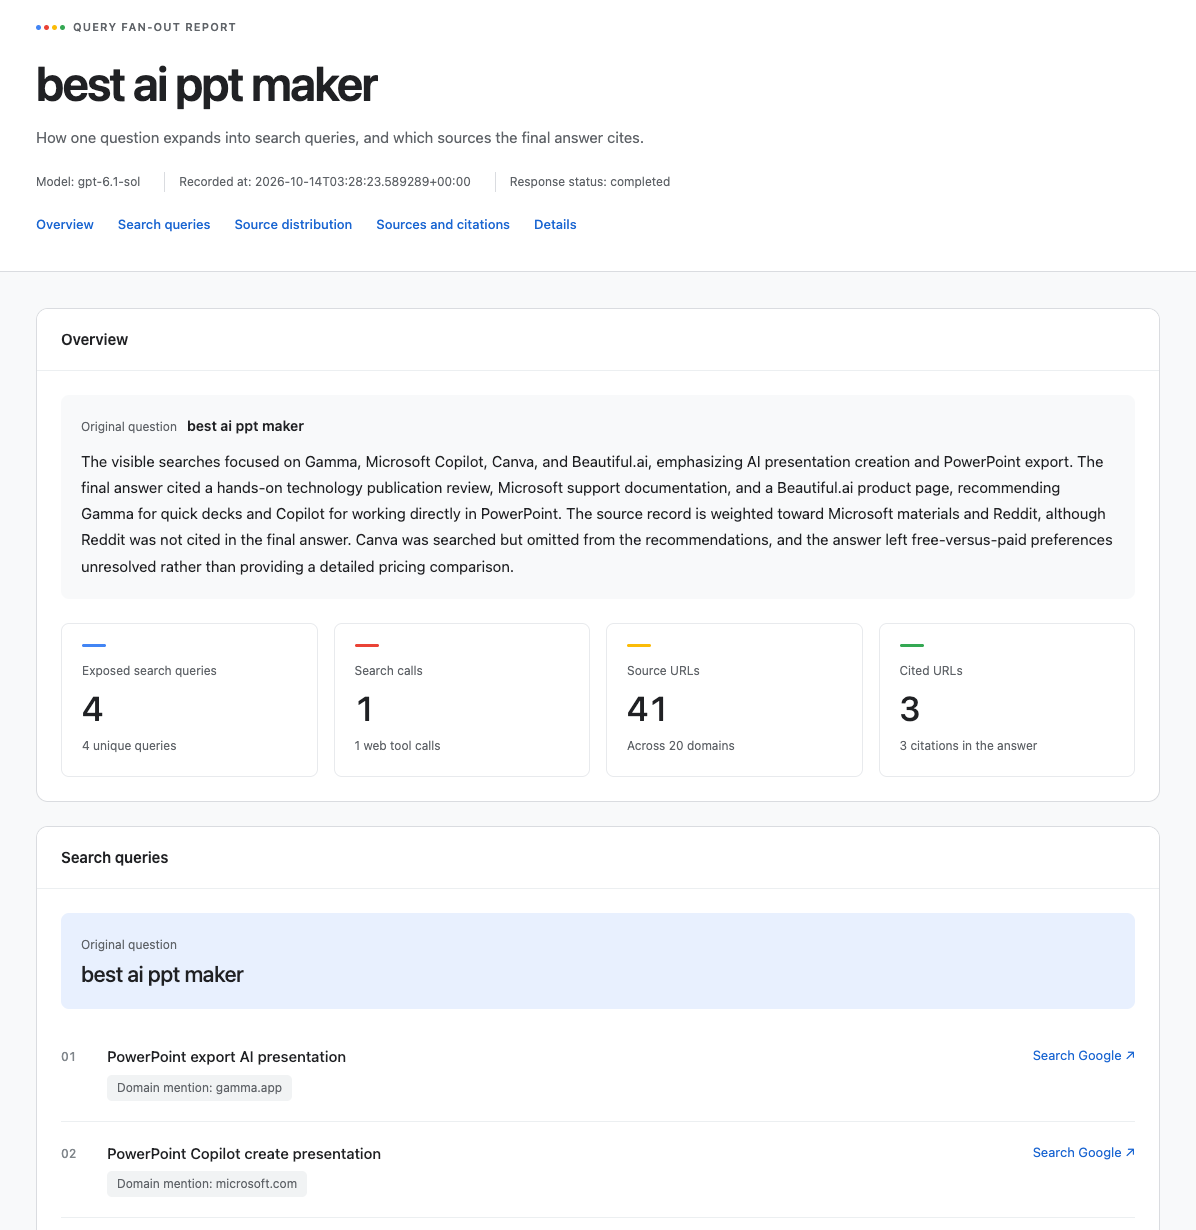
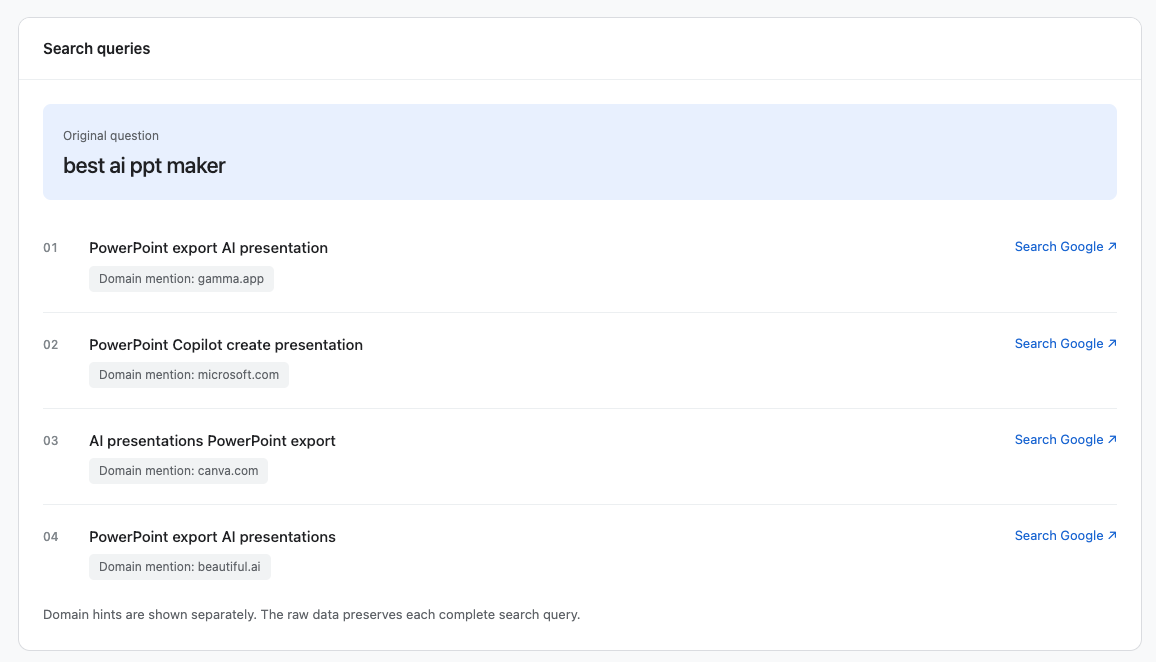
这次 API 返回了 1 次 Web Search 工具调用,但这次调用里实际暴露了 4 条搜索词:
另外搜索返回了 41 个来源 URL,最终答案则引用了 3 个 URL。
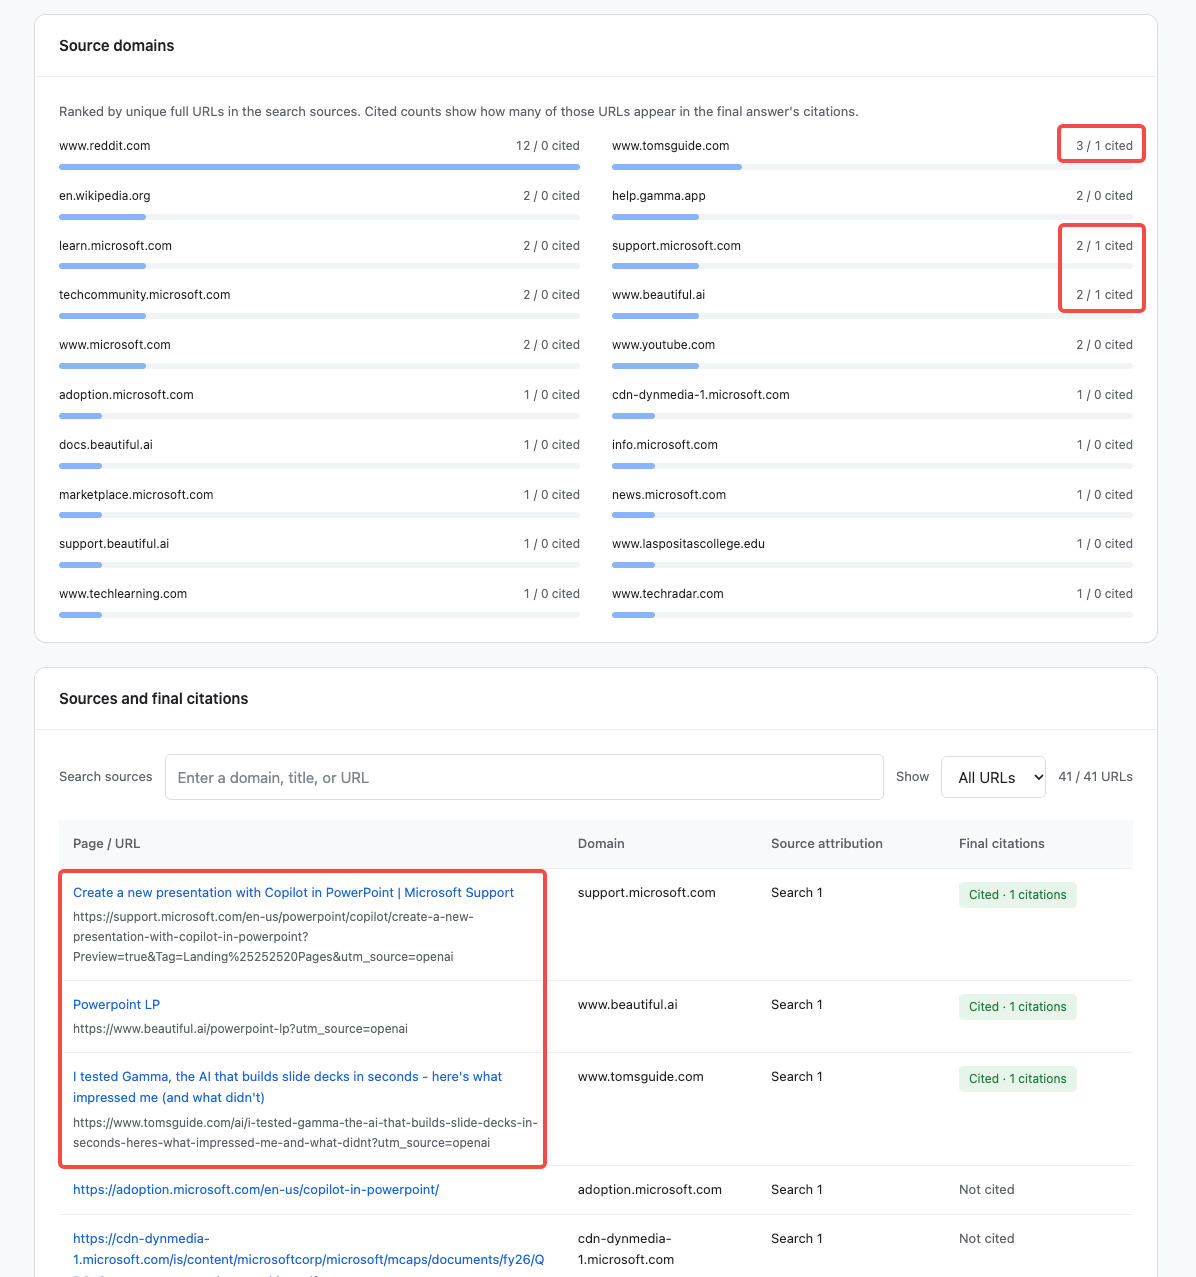
这些结果有啥用呢?
1、「内容方向」:如果你要做营销内容,你要创作的主题方向
2、「内容竞品」:对应来源 & 被引用的内容 URL 都是你参考对象
3、「内容营销渠道」:这些 domains 有些就是你后续做内容营销的平台
对 GEO 研究来说,这些差异正是最值得分析的部分。
开源 + 免费,欢迎用起来、提 Issue、一起把它做得更实用。
GitHub 地址:
https://github.com/JeffLi1993/open-growth-skills
四、怎么用?
它是一个标准 Agent Skill,仓库发布后可以这样安装:
npx skills add github.com/JeffLi1993/open-growth-skills --skill chatgpt-fanout-queries |
然后直接把要研究的问题交给 Agent。例如:
用 chatgpt-fanout-queries 分析:best ai website builder for a SaaS startup |
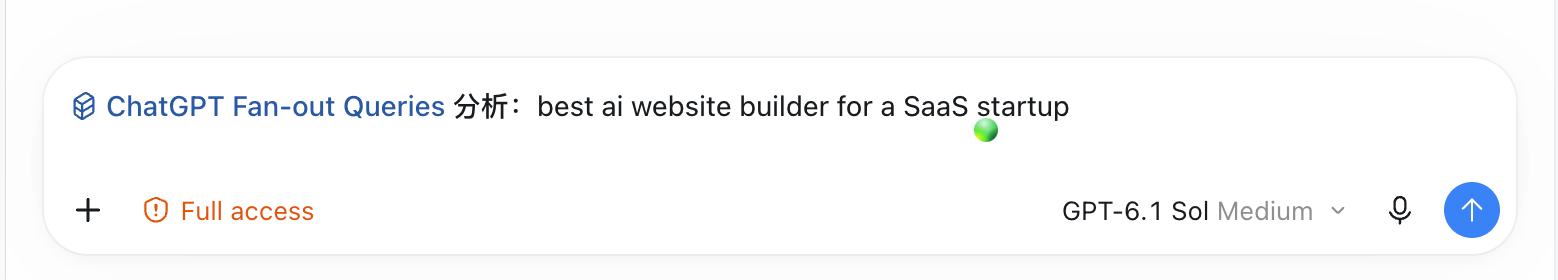
这个注意,需要你先配置下 Open API 的 key:在 .env 里配置你自己的 OPENAI_API_KEY 和默认模型即可。API Key 只放在本地,不会写入研究报告。
五、这个 Skill 刻意保持克制
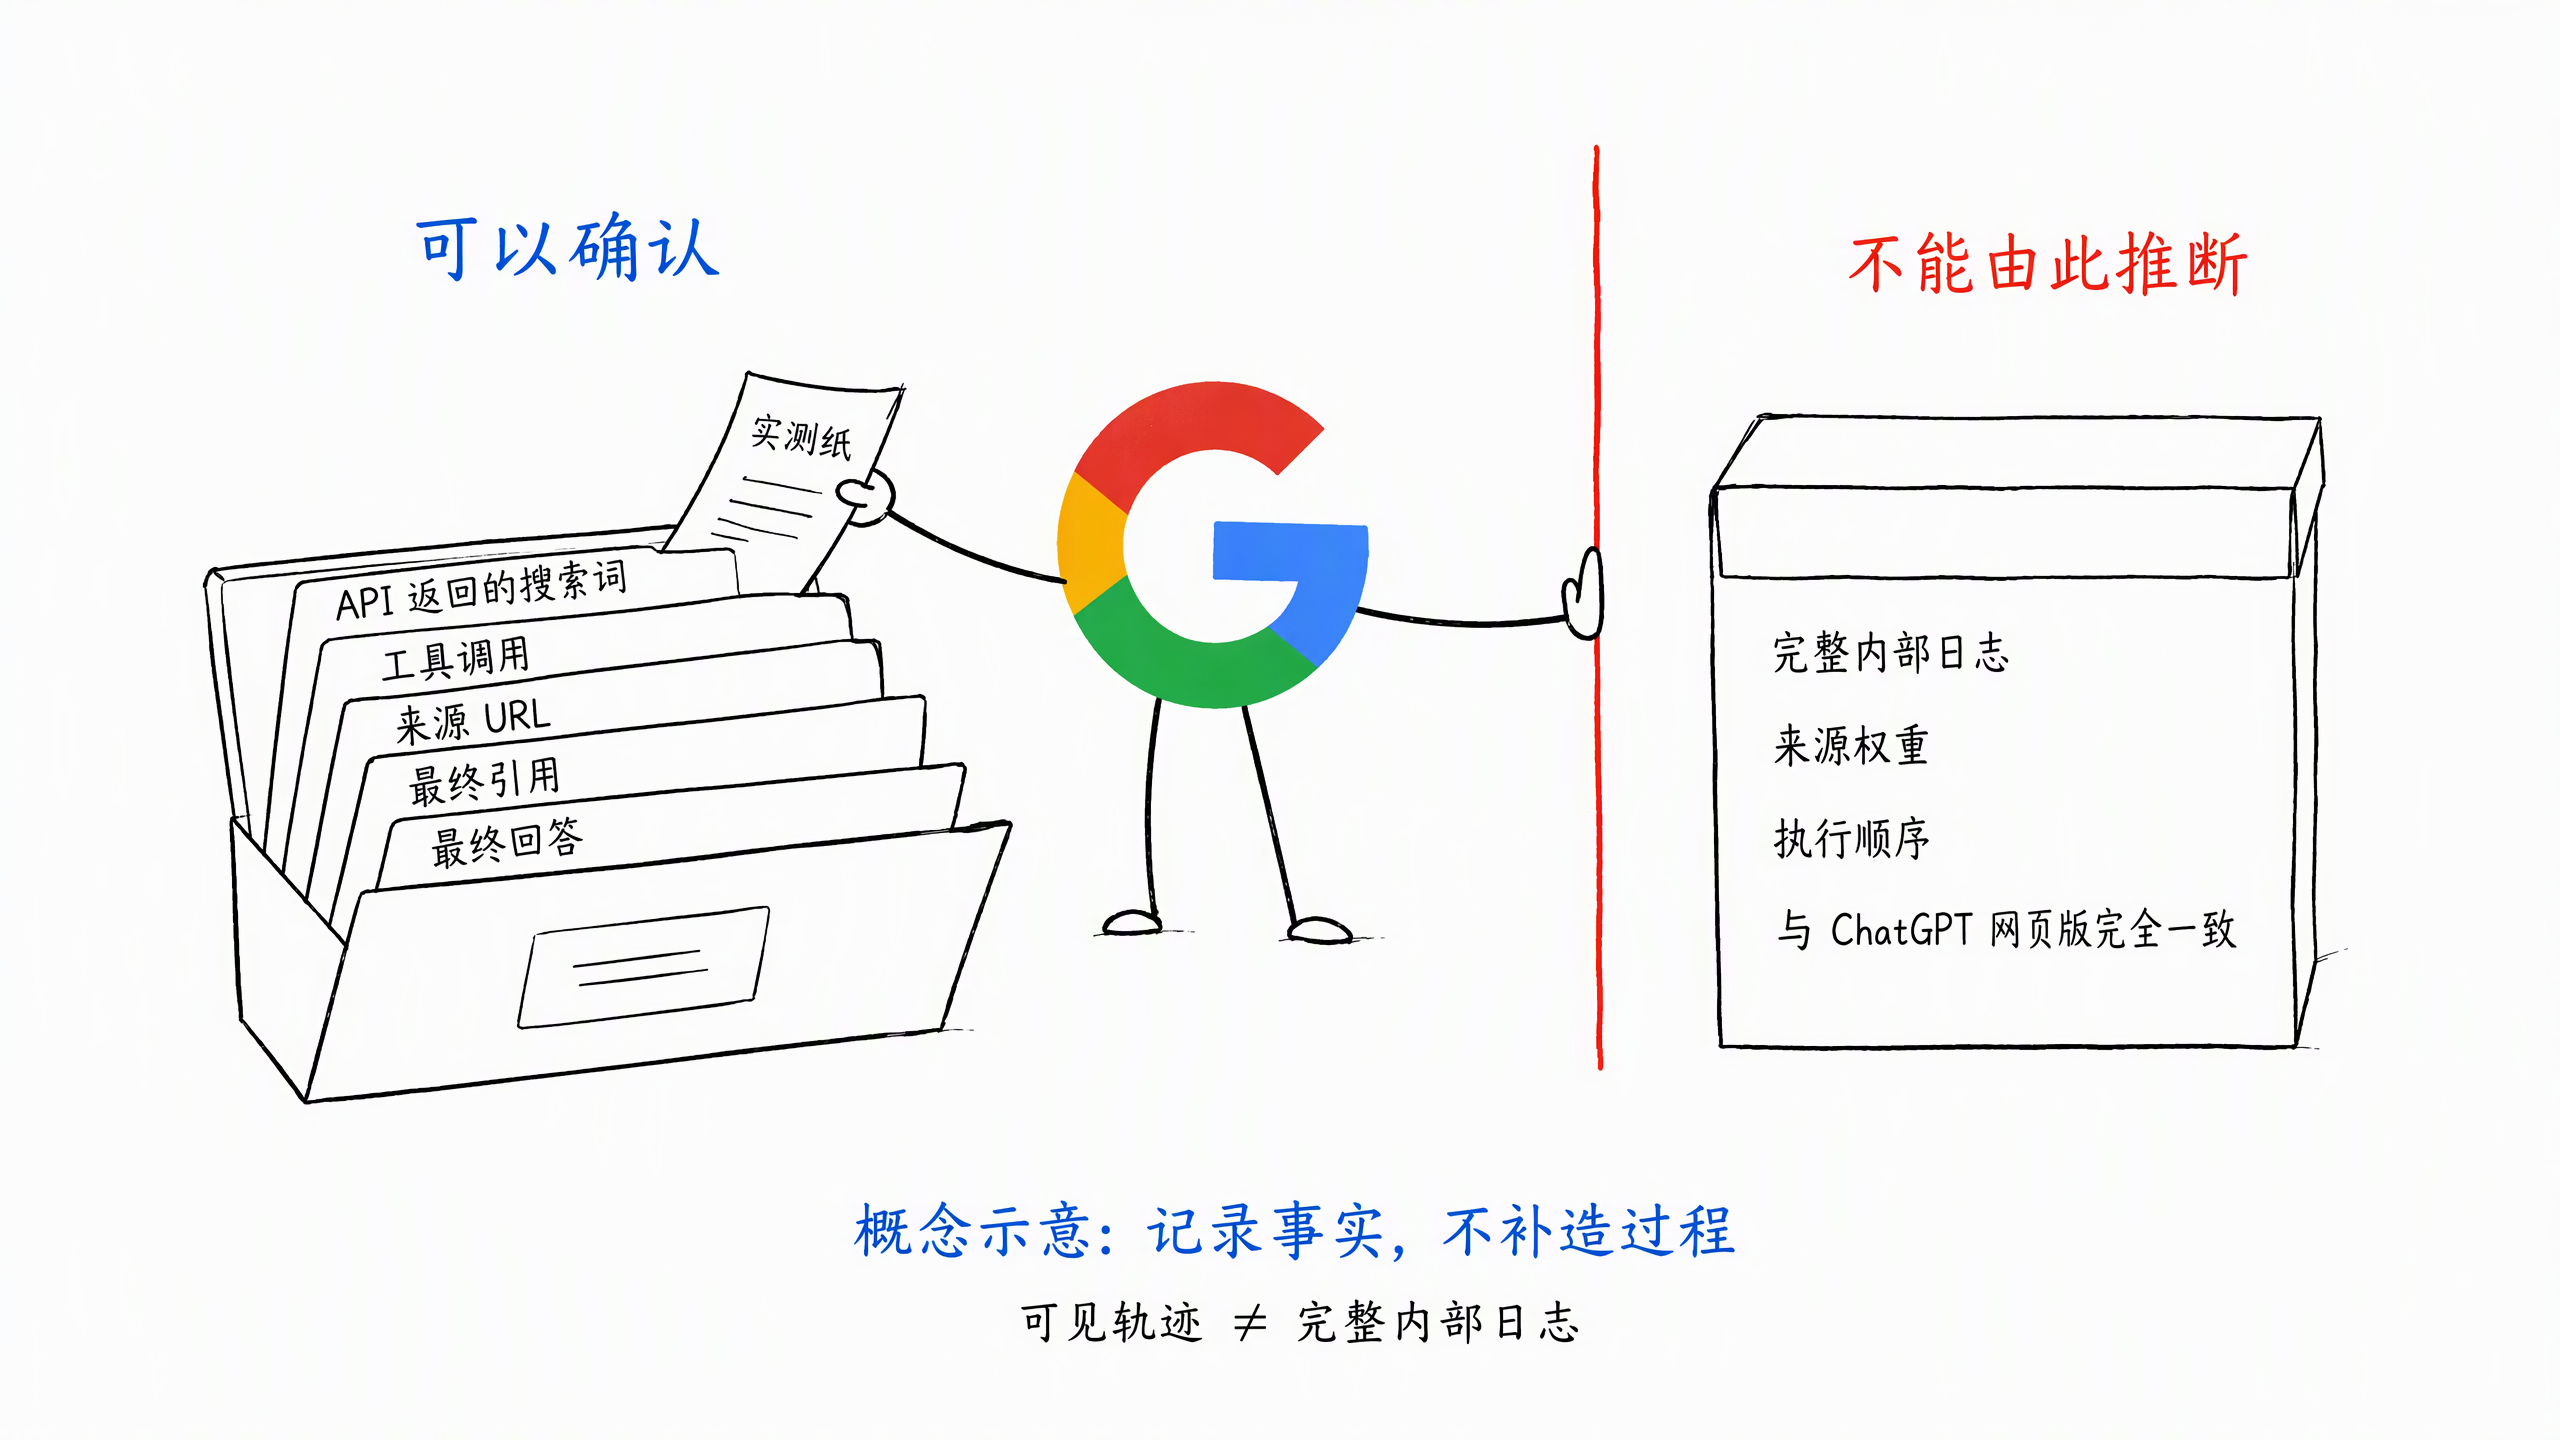
有些事它是故意不做的:
API 没给搜索词,不会根据答案去猜
搜到的来源和答案里引用的来源分开算,不混成一个数
不会因为某个结果排在前面,就说它更重要、更可信
不会说 API 跑出来的结果就等于 ChatGPT 网页版
不是做不到,而是不该做。
做 GEO,数据少一点没关系,最怕的是把猜的当成真的。
最后说两句
我做这个 Skill,不是为了又做一个输入问题、输出答案的 AI 工具。
它真正想解决的是:当你在研究 AI 搜索时,怎么把一次本来很难复核的过程,变成一组可保存、可对比、可重新解析的研究产物。
问题是怎么被展开的,哪些页面出现在搜索来源中,哪些又真正出现在答案里 - 把这些看清楚,才能让 GEO 从猜模型喜欢什么,走向对可见证据分析 & 内容方向的建设。
GitHub 地址:
https://github.com/JeffLi1993/open-growth-skills
觉得有用欢迎给个 Star ⭐,有想法就提 Issue,也欢迎拿你的真实 GEO 问题来测试。